検出した問題を、日々の変更へ戻せるか
AIがコードから脆弱性を見つけた、という発表が増えている。開発チームが知りたいのは、その後だ。報告は本当に再現できるのか。提案された修正は原因を取り除くのか。正常な利用を壊さず、保守担当が通常の変更として受け入れられるのか。この連続した仕事を短くできて初めて、検出能力が製品の安全性につながる。
Googleが2026年9月に公表した基盤コードの検査は、その仕事を開発工程に組み込んだ事例だ。同社は数億行のコードに対する個々の変更を継続的に検査し、月に数百件の脆弱性が入り込むのを防いでいると報告した。変更前の検査では、局所的な脅威モデルとコード構造を使って報告を絞り、修正案を元の変更の人によるレビューへ渡す。夜間の統合試験では、複数の変更をまたぐ問題も調べる。
ここから筆者が重視するのは、検出器の順位よりも、検出から修正の採用までのつながりである。変更単位なら、誰がどの機能を変えようとしているかを説明しやすい。保守担当は、抽象的な警告一覧ではなく、自分がレビューしている変更と照らして判断できる。ただしGoogle内部の報告件数から、別の組織で同じ精度や負担削減が得られるとは言えない。
Firefoxでは、小さな再現試験が修正を動かした
修正を受け取る側の証言として重要なのが、MozillaによるAnthropicとの共同作業の報告だ。AIを使った報告には誤検出が多く、確認の負担になる場合があるとMozillaは述べている。今回の報告には最小限の再現試験が含まれ、Firefoxの技術者が問題を素早く検証できた。修正はFirefox 148に向けて取り込まれ、共同作業の結果として22件のCVEが発行された。うち14件は深刻度が高い問題だった。
この事例では、AIの発見、人による確認、技術者による修正、利用者へ届くリリースを区別できる。22件という数字は実際に修正へ進んだ成果を示すが、AIが出した全候補の正答率ではない。また、モデルが修正と公開までを一人で完了した事例でもない。保守担当が確認できる材料を受け取ったことが、発見を製品の更新へ変えた。
報告の価値は、説明文の長さでは測れない。入力、対象の版、問題が起きる操作、期待した動作がそろえば、受け手は自分の環境で反証できる。再現できない警告を何十件も追加するより、確認可能な一件を渡す方が修正の着手につながりやすい。これはAIの能力を控えめに見るためではなく、その能力を保守の仕事へ接続するための条件である。
クラッシュした場所と、直すべき原因は違う
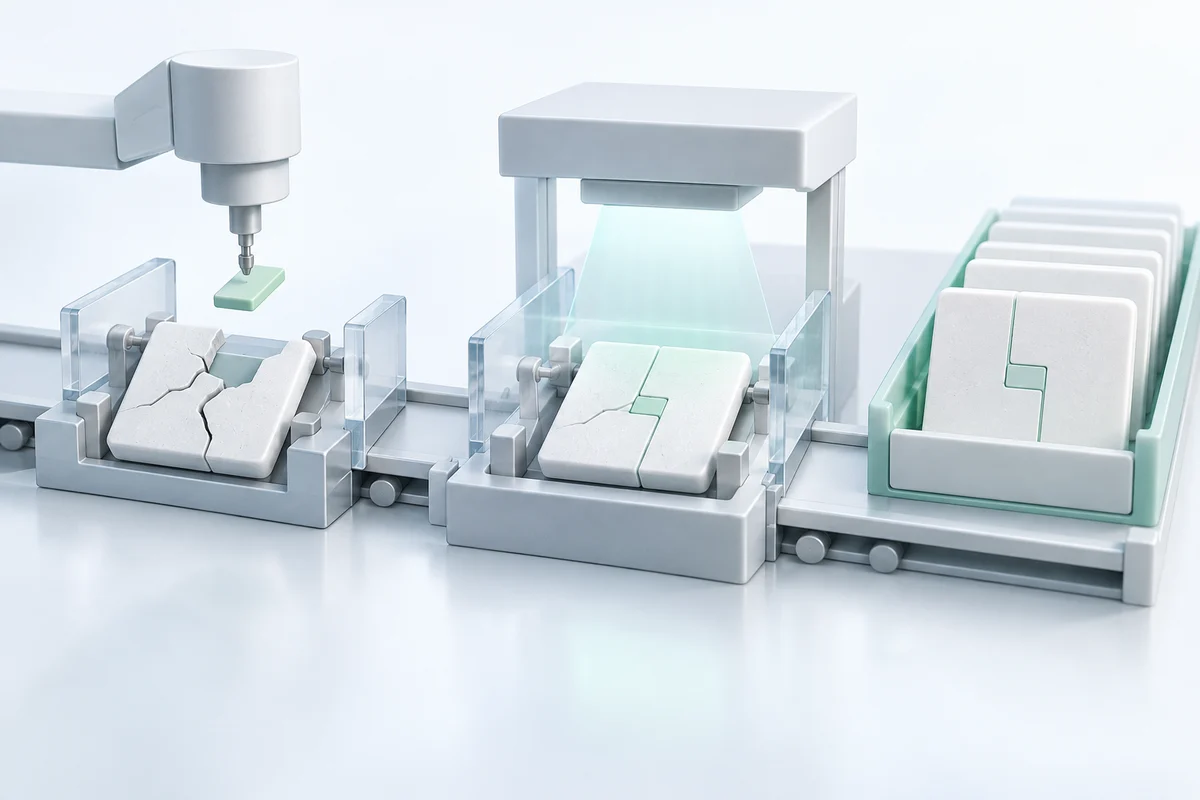
再現できても、修正が正しいとは限らない。Google DeepMindのCodeMenderが示したXML解析の例では、観測された症状はヒープ上のバッファオーバーフローだったが、原因はXML要素のスタック管理にあった。クラッシュする行の周囲だけを変更すると、原因を残したまま一つの入力を止めることがある。
CodeMenderの説明には、静的・動的解析、修正前後の比較試験、ファジング、SMTソルバー、モデルによる批評が含まれる。発表時点の半年間で72件のセキュリティ修正を上流プロジェクトへ取り込んだと報告し、提出前には研究者がすべての修正を確認していた。複数の手段で原因と動作を調べ、人の確認へ渡す構成が見える。
ただし、道具が多いこと自体は正しさの証明にならない。モデルによる批評も誤る可能性があり、既存の試験が重要な利用条件を含まなければ回帰を見逃す。72件の成功例を評価するには、試行総数、提出に至らなかった修正、保守担当が変更した量も必要だ。採用件数は有用な指標だが、それだけでは検証費用や失敗の割合を説明できない。
GitHubの修正提案は、検証できる範囲も示す
この仕組みを一般の開発環境へ近づけるのが、GitHubが7月に公開プレビューを始めたagentic autofixだ。警告を割り当てると、エージェントが関連ファイルを調べ、修正し、CodeQLを再実行して試行を重ね、レビュー用のドラフトPull Requestを開く。単一の修正候補を表示する方式より、調査と検証を変更の提出までつなげている。
一方、現在の公式文書は保証の限界を明記している。再検査に使うのはCodeQLのcode-scanningクエリ群で、独自クエリやsecurity-extendedクエリによる警告の解消は確認できない。他社の検査ツールが出した警告に対する修正品質も保証されない。通常のCopilot Autofixは一つの候補を生成し、利用者が確認して適用する方式として区別されている。
したがって、Pull Requestに「検証済み」と書くなら、その対象を具体化する必要がある。どの解析を再実行したか、どの再現入力が通らなくなったか、どの正常系を確認したかを記録する。警告が消えたという観測から、すべての関連する脆弱性と回帰が消えたという結論へ飛ばないことが、レビューの判断を助ける。
攻撃の再現入力だけで合格にすると、何を見逃すか
この区別を実験で検討したのが、9月公開のPatchBench論文である。C/C++の脆弱性修正を対象に、与えた攻撃再現入力でクラッシュしなくなることだけを合格条件にする問題を調べた。エージェントは原因を直さず症状を抑える場合があり、過去の修正の記憶も評価をゆがめ得る。研究は脆弱性を異なるコードへ移すなどして、セキュリティと正常な動作の両方を検証した。
AIxCC上位3チームを含む11エージェントの比較では、再現入力だけによる判定は修正の成功率を平均1.83倍に過大評価した。この数値は同論文の対象と検証方法の比較であり、あらゆる実運用の誤修正率ではない。それでも「元の攻撃が通らない」と「原因を直し、必要な機能を残した」の間に、測定すべき差があることを示す。
たとえば、危険な入力が通る機能を丸ごと無効にすれば再現試験は通るかもしれない。だがその機能を必要とする利用者にとっては修正にならない。この仮想例が説明するのは、攻撃を拒否する試験と、許可される利用を維持する試験が別々に必要だという点だ。合格条件を広げることで、エージェントが最短で消すべきものも、症状から原因へ変わる。
発見、修正、採用、公開を同じ件数にしない
DARPAのAI Cyber Challenge最終結果は、この違いを数え分けている。競技で意図的に組み込まれた脆弱性は54件が発見され、43件に修正が生成された。別に、意図的に組み込まれていない実際の脆弱性18件が見つかり、11件の修正が提供された。後者は保守担当への開示が進む成果であり、競技結果だけで全件が製品へ公開済みとは読めない。
CyberGymE2Eは、139のオープンソースプロジェクトに由来する920件の脆弱性で、発見、再現、修正を含む評価を提案している。こうした研究は連続した作業を比較する助けになる。ただし、過去の脆弱性を用いた環境での成功と、現在の保守担当がレビューしリリースする仕事は、対象も責任も異なる。
問題を発見した
疑わしい箇所を示した段階。到達条件と再現性を確認する必要がある。
修正を検証した
再現試験と正常な利用を確認した段階。試験の範囲を明示する。
保守担当が採用した
プロジェクトへ取り込まれた段階。人が加えた変更と確認時間も成果に含める。
利用者へ公開した
修正版が届く段階。取り込みと配布の間の遅れも追う。
導入効果は、確認の手間を含めて測る
筆者なら、既存の検査で扱っている一種類の警告から導入する。AIの提案には再現試験、原因の説明、修正差分、正常系の検証結果を添え、保守担当は通常の変更と同じ場所で判断する。自動採用の前に、この材料で確認時間が減るかを確かめる。既存の解析やファジングは、AIの判断を検証する比較対象としても使える。
記録するのは採用された修正だけではない。誤検出、再現失敗、修正の失敗、時間切れ、人が大きく書き直した提案も残す。従来の対応と比べて、確認から公開までの時間、再発や回帰、検査と人の作業を合わせた費用が改善するかを見る。重大な一件を見つける価値は大きいが、それを日常的に確認できる体制かどうかは別に測る必要がある。
Firefoxの受け入れ事例とGoogleの開発工程への組み込みは、AIの発見を修正へ運ぶ方法が具体化していることを示す。PatchBenchとGitHubの制約は、検証の範囲を省略するとその成果を過大に読んでしまうことを示す。AIによるコード防御の実用性は、モデルが何件を指摘したかに加えて、人が根拠を確認し、必要な機能を保った修正を利用者へ届けられるかで判断したい。