
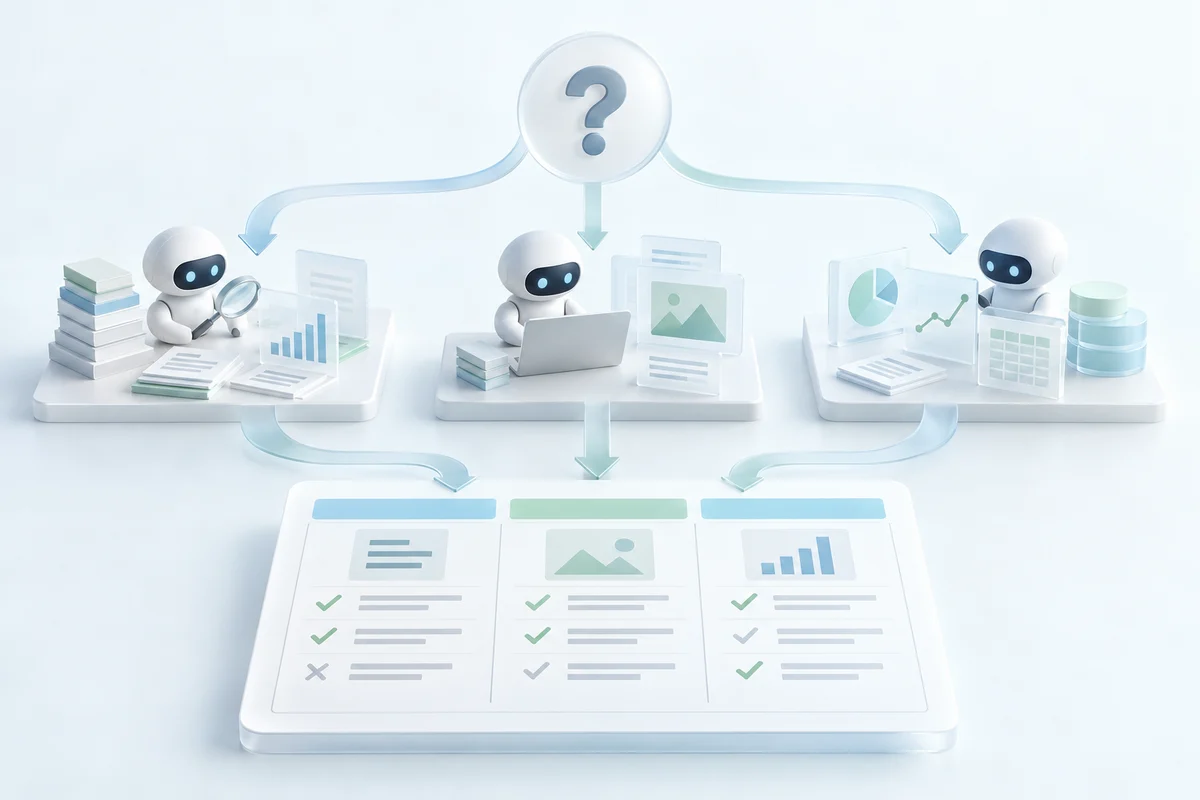
三つの調査が終わっても、比較は完成しない
新しく使うソフトを選ぶため、三つの製品をAIに調べてもらう。 担当を分ければ、各社の資料を同時に読める。 ところが戻った結果を見ると、一つは無料版、一つは法人版、もう一つは以前の仕様を調べていた。 三つとも完成を報告しているが、人は条件をそろえる調査をやり直す。 これは分担の仕組みを考える想定例だ。 待ち時間が短くなることと、判断できる結果が早く届くことは同じではない。
下位エージェント(subagent)は、主担当から限定した仕事を受け取り、その範囲で調査や実行を進めるエージェントである。 本稿は2026年3月30日までのOpenAI、Anthropic、Google、Microsoft、AWSの公表資料から、仕事をどこで分けるかを考える。 各社が同じ構成へ移ったという説明や、製品の速度順位を示すものではない。
私の判断は、分担の単位を「調査担当」のような役割名だけで決めず、何を受け取り、どこまで自分で進め、何を返せば次の判断へ進めるかまで設計する、というものだ。 分けた結果を人が最初から検証し直すなら、担当数を増やす価値は小さくなる。 独立した仕事を進めつつ、統合に必要な条件と根拠を残すことが出発点になる。
小型モデルを使うことと、仕事を同時に進めること
OpenAIの3月17日のGPT-5.4 miniとnanoの発表は、Codexで大きなモデルが計画や統合を担い、miniへコード探索、ファイルの確認、資料処理などを並列に委任する例を示す。 nanoは分類や抽出などの用途に位置付けられるが、この発表ではAPIでの提供であり、Codexの下位担当として説明されているのはminiだ。
ここには二つの選択がある。 作業に応じてモデルを選ぶことと、複数の作業を同時に進めることだ。 小型モデルへ順番に任せる構成も、同じモデルで複数の担当を動かす構成も考えられる。 単価を下げた効果と、並列にした効果を一つの数字へ混ぜると、何が改善したか分からなくなる。
想定例で製品名と版の抽出だけを任せるなら、確認できる入力と返却形式を絞れる。 一方、資料間の矛盾を解き、用途に合う製品を選ぶ仕事には追加の探索と判断が要る。 「下位担当だから簡単」とは限らない。 狭い仕事へ分けた後も、その担当が曖昧さを解く力を持つかを確かめたい。
前の結果を待つ仕事を、並列に置かない
三製品の資料収集は、利用目的と対象の版を先に決めれば独立に進めやすい。 しかし比較表の統合は収集結果を待つ。 統合後の推奨理由の確認も、その表が必要になる。 同じ「三工程」でも、収集を三方向へ分けることと、収集・統合・確認を同時に始めることは違う。
同じ条件を渡す
利用目的、対象の版、比較する機能、資料の対象日をそろえる。条件を決める前に各担当の調査を始めない。
独立した探索を任せる
製品ごとに資料を探し、食い違いを確かめる。他の製品の結論を待たずに進められる範囲を分ける。
根拠を伴う結果を返す
事実、URL、該当箇所、確認できない項目を返す。調査に失敗したことを、機能が存在しないという結論へ変えない。
比較できるかを判断する
版や提供条件がそろった結果から比較する。不足があればその担当へ戻し、未確認の差を推奨理由にしない。
これは本稿の想定工程であり、四つのエージェントを作る要件ではない。 決められた三つのURLを取得するだけなら、ツール呼び出しの並列化で足りる場合がある。 資料から新しい論点を見つけ、別の原典へ進む判断まで任せたいときに、下位エージェントを使う理由が生まれる。
コード作業でも、原因の分析、修正、修正後のテストは前の結果に依存する。 独立したモジュールの確認は並列にできても、同じ修正対象を別々に書き換えると統合が必要になる。 職種のような役割名より、誰がどの結果を待つかから分担を決める方が、受け渡しを説明しやすい。
文脈を分けても、根拠を落とさない
AnthropicのClaude Agent SDKの設計記事は、下位担当が独立した文脈を持ち、関連する情報だけを調整役へ返す仕組みを説明する。 製品ごとに長い資料を読んでも、主担当がその全履歴を抱える必要はない。 この文脈管理は、並列速度とは別の利点として検討できる。
ただし、短い結論だけを返すと、比較に必要な条件まで消える。 「検索機能あり」という要約では、法人版限定か、外部接続が要るか、どの版で確認したかが分からない。 私は、比較表の各項目から原資料へ戻れる形を勧める。 本文をすべて複写する必要はないが、結論を変え得る条件を圧縮で落としてはいけない。
最初の想定例なら、担当は確認した版と機能を根拠に結び付け、確認できない項目を空欄とは別に返す。 主担当は同じ条件で比較できる項目だけを統合する。 三つの担当が同意していても、同じ古い資料を読んだだけなら、新しい裏付けが三つ増えたことにはならない。
反対に、主担当の会話や全資料を毎回すべて渡せば、文脈を分けた利点は小さくなる。 共通の利用目的と制約は渡し、その担当が扱わない資料は必要なときに参照できるようにする。 共有を減らすこと自体ではなく、判断に必要な情報を保って入力を限定することが目的だ。
順序を固定する仕組みと、担当を選ぶ仕組み
Google ADKの3月30日時点の文書は、順次、並列、反復の制御を、モデルに毎回判断させずに行うワークフローを示す。 下位担当の内部ではモデルを使えても、実行順序は決められた規則で制御する。 既知の手順を扱うなら、調整役が毎回順番を考える必要はない。
同じ時点の調査コードの例は、三つの担当の要約を別々の項目へ保存し、全員の処理が終わってから統合担当へ渡す。 並列に走らせることと、結果をどう共有するかを分けている。 例の要約指示だけで本稿の根拠条件を満たすわけではなく、順序が正しくても調査内容の正しさは別に確かめる必要がある。
Bedrockの2025年3月の一般提供の発表には、supervisorが仕事を分解して統合する方式と、簡単な依頼を専門担当へ直接振る方式がある。 後者も複雑な依頼では調整役へ戻る。 たとえば一製品の仕様確認と三製品の比較では、必要な調整が違うという見方ができる。 この例は本稿の解釈であり、振り分けによる費用削減を測定したものではない。
固定した工程と、結果に応じて探索先を変える担当は組み合わせられる。 各社の名称を並べるより、順序を誰が決めるか、担当を誰が選ぶか、結果をどこへ置くかを比べる方が、自分の業務に必要な仕組みを選びやすい。
会話の続きと、処理の続きは別に残す
Microsoft Agent Frameworkの3月30日時点のセッションの例は、複数の担当を含むワークフローを一つのエージェントとして呼び、会話の履歴を次の呼び出しへ渡す。 履歴を保存用の形式へ変え、そこから戻す例もある。 内側の分担を保ちつつ、利用者が前の依頼に続けて話せる構成だ。
しかし「前に何を頼んだか」を残すことと、「どの調査が終わったか」を残すことは違う。 同時点のチェックポイントの例は、会話履歴と処理途中の記録を分けて扱う。 例で使う保存先はメモリ内であり、これだけでプロセスの終了後も復旧できるとは言えない。 コード例は設計を示すもので、本稿で実行や障害復旧を検証した結果ではない。
想定調査で一担当だけが失敗したときには、終わった二担当の結果、未完了の担当、使った比較条件を残す。 失敗した担当をやり直した後は、どの結果が置き換わったかも分かるようにする。 途中で対象の版を変えるなら、既存の二結果が新しい条件に合うかを再確認する。 再開できても、違う条件の結果をつないでしまえば比較は成立しない。
主担当は、結果を並べるだけでは済まない
分担した調査では、資料を読む負担の一部がAIへ移り、主担当には条件の食い違いを見つける仕事が残る。 人が最終的な選択をするなら、採用する根拠と未確認の条件を見せる必要がある。 長い完成報告を三つ渡すだけでは、その人が再び比較表を作ることになる。
各担当には、何が分かれば終了してよいか、資料が見つからないときに何を返すかを決めておく。 主担当は不足を確認して追加調査の範囲を絞る。 担当全員に最初から調べ直させる方法は、独立した探索の利点を失いやすい。 早く返った結果を採用する場合も、未完了の調査が推奨を変え得るかを示したい。
役割名は操作権限を制限しない。 調査だけを任せるなら、実行設定でも不要な更新操作を与えない。 成果物は別々に返し、共有ファイルへの反映や外部送信を行う担当を明示する。 ここで分担するのは仕事であり、最終判断の責任が自動的に消えるわけではない。
節約した単価より、増えた総作業を見る
Anthropicの2025年6月の調査システム記事は、独立した方向へ探索を広げる利点と、依存関係が多い仕事での難しさを報告する。 同社のデータでは、マルチエージェントは通常のチャットの約15倍のトークンを使った。 比較相手は単一エージェントではなくチャットであり、あらゆる分担の費用倍率ではない。 それでも、委任すれば必ず安くなるという説明はできない。
三つの調査が同時に進んでも、最後の担当を待つ時間、依頼の作成、結果の統合、追加調査は残る。 大きいモデルの使用量が減っても、小型モデルの呼び出しと再試行が増えれば総費用は変わる。 人が条件をそろえ直す時間も、利用者が判断できる結果までの所要時間へ入れる必要がある。
比較では、単一担当と分担構成に同じ依頼、対象資料、品質条件を与える。 同じ総予算で品質を比べる試験と、同じ品質を満たすまでの時間と費用を比べる試験は分けて報告する。 モデルも変えるならその差を記録し、並列化だけの効果とは説明しない。 複数回試し、事実の誤り、比較項目の欠落、不採用の結果、統合と人の修正を含めて確かめたい。
次の判断へ渡せる範囲で、仕事を分ける
一製品の短い仕様確認なら、単一担当や固定した取得手順で足りるかもしれない。 三製品を独立に探索し、原資料へ戻れる結果を集められるなら、下位担当を使う理由がある。 分担の価値は、AIが同時に働いている見た目ではなく、必要な深さで調べた結果から、人が判断を進められるかにある。
まず一つの分担を試し、入力、探索範囲、返す根拠、統合の担当をそろえる。 待ち時間の短縮より統合の手戻りが大きければ、分け方を見直す。 モデル、文脈、順序、保存先を個別に選べることを使い、判断できる結果までの仕事が改善した分担を残す。 それが、本稿で提案する下位エージェントの使い方だ。